
Ⅰ. 서 론
Ⅱ. 재료 및 방법
1. 연구 흐름
2. 영상자료와 분석 방법
3. 모델 구조
4. 정확성 평가 방법
Ⅲ. 결과 및 고찰
1. 세그멘테이션 모델
2. 이미지 분류 모델 학습
3. 모델 성능 평가
Ⅳ. 요약 및 결론
Ⅰ. 서 론
논 토양은 담수에 의해 산소 공급이 제한되어 혐기적 환경이 발달하며, 그 결과로 메탄이 대량 배출된다 (Hedderich and Whitman, 2006; Gwon et al., 2022). 한편, 물떼기 (중간 낙수)와 같은 논물관리 활동은 농업용수 사용을 줄이는 효과는 물론, 논에서의 메탄 배출량도 줄여줄 수 있다는 연구 결과가 보고되었다 (Toma et al., 2021). 농림축산식품부에서는 이러한 탄소중립 정책 확대를 위해 보조금을 통한 논물떼기 장려 시범사업을 시행하고 있다. 시범사업에서 논물떼기에 대한 이행점검은 농업인이 이행점검용 모바일 웹을 통해 직접 촬영한 논 이미지를 제출하고, 이를 서면 또는 현장 점검하는 방식으로 이루어진다 (MAFRA, 2025). 그러나 제출한 사진을 육안으로 판독하거나 한정된 인력으로 현장을 직접 점검하는 현행 방식은 광범위한 대상지의 관개 상태를 신속하고 정확하게 파악하는 데 한계가 있다. 따라서 논의 담수와 비담수 여부를 모니터링하고 효율적으로 관리하기 위해서는 이를 자동으로 정확하게 판별하는 기술이 필요하다.
최근 딥러닝 (Deep Learning) 기반 이미지 분류 모델은 방대한 데이터로부터 효과적인 특징 학습 능력을 바탕으로 다양한 분야에서 높은 성능을 보이며 자동화된 판독 기술로 주목받고 있다 (LeCun et al., 2015; Shrestha and Mahmood, 2019). 특히, 합성곱 신경망 (Convolutional Neural Network, CNN)을 활용한 딥러닝 모델은 이미지에서 특징을 직접 학습하여 수동으로 특징을 추출해야 했던 기존 컴퓨터 비전 (computer vision) 방식의 한계를 극복하고, 이미지 분류 작업에서 높은 정확도를 달성하였다 (Khan et al., 2020; Wang et al., 2020; Archana and Jeevaraj, 2024). 정밀 농업 분야에서 CNN 기반의 딥러닝 모델은 지도 학습 (supervised learning), 전이 학습 (transfer learning), 그리고 데이터 의존성을 완화하는 퓨샷 러닝 (few-shot learning)과 같은 다양한 학습 전략을 활용하여 광범위하게 적용되고 있다 (Wang et al., 2022). 하지만, 이행점검을 위해 수집되는 논 이미지는 촬영 조건의 비일관성과 다양한 배경 요소의 혼재로 인해, 기존의 딥러닝 모델을 단순 적용할 경우 성능 저하가 발생할 수 있다. 본 연구에서는 이러한 문제를 해결하기 위해 하드 어텐션 (hard attention) 메커니즘을 도입하였다.
하드 어텐션은 모델이 이미지 내의 특정 영역에 선택적으로 집중할 수 있도록 하는 기법으로 (Wandell, 1995), 불필요한 배경 정보의 영향을 최소화하고 분류에 결정적인 영역에 대한 학습을 강화한다 (Ba et al., 2014; Gregor et al., 2015). 이를 통해 모델은 관개 상태 판별에 직접적으로 관련된 시각적 특징에 집중할 수 있다. 이러한 접근은 단순히 원본 이미지를 학습하는 것이 아닌, 분류 판단에 핵심이 되는 영역을 선별적으로 활용함으로써 딥러닝 모델의 정확도를 향상시킬 수 있다 (Mnih et al., 2014; Fu et al., 2017; Elsayed et al., 2019). 어텐션 메커니즘은 표준화된 촬영 조건으로 인해 영상 특성의 일관성이 높고 관심 영역이 명확하게 한정되어 있는 의료 영상 분석 분야에서, 그 효과성이 광범위하게 입증되었다 (Shin et al., 2020). 이러한 의료 영상 분야에서의 성공적인 적용 사례를 고려할 때, 하드 어텐션 메커니즘은 논 이미지 내 관심 영역인 수면을 효과적으로 강조하여 관개 상태 분류의 정확도를 향상시킬 것으로 판단되었다.
본 연구의 목적은 하드 어텐션 기반의 딥러닝 모델을 적용하여 논 이미지의 관개 상태를 실시간으로 정확하게 분류하고, 실제 논 이미지를 대상으로 한 실증적 성능 평가를 통해 그 유효성을 검증하는 것이다.
Ⅱ. 재료 및 방법
1. 연구 흐름
본 연구의 전체적인 흐름은 Fig. 1에 나타난 바와 같이 데이터 준비, 모델 학습, 성능 평가의 세 단계로 구성된다. 먼저, 현장에서 직접 취득한 논 이미지를 기반으로 데이터 세트를 구축하였다. 수집된 원본 이미지를 바탕으로 상용 어노테이션 도구인 Labelbox를 이용하여 이미지 내 수면을 정밀하게 분할 (segmentation)하고, 이를 통해 생성된 이진 이미지 (binary image)를 확보하였다. 최종적으로, 원본 이미지와 이에 대응하는 수면 마스크가 한 쌍을 이루는 데이터 세트를 구성하였다.
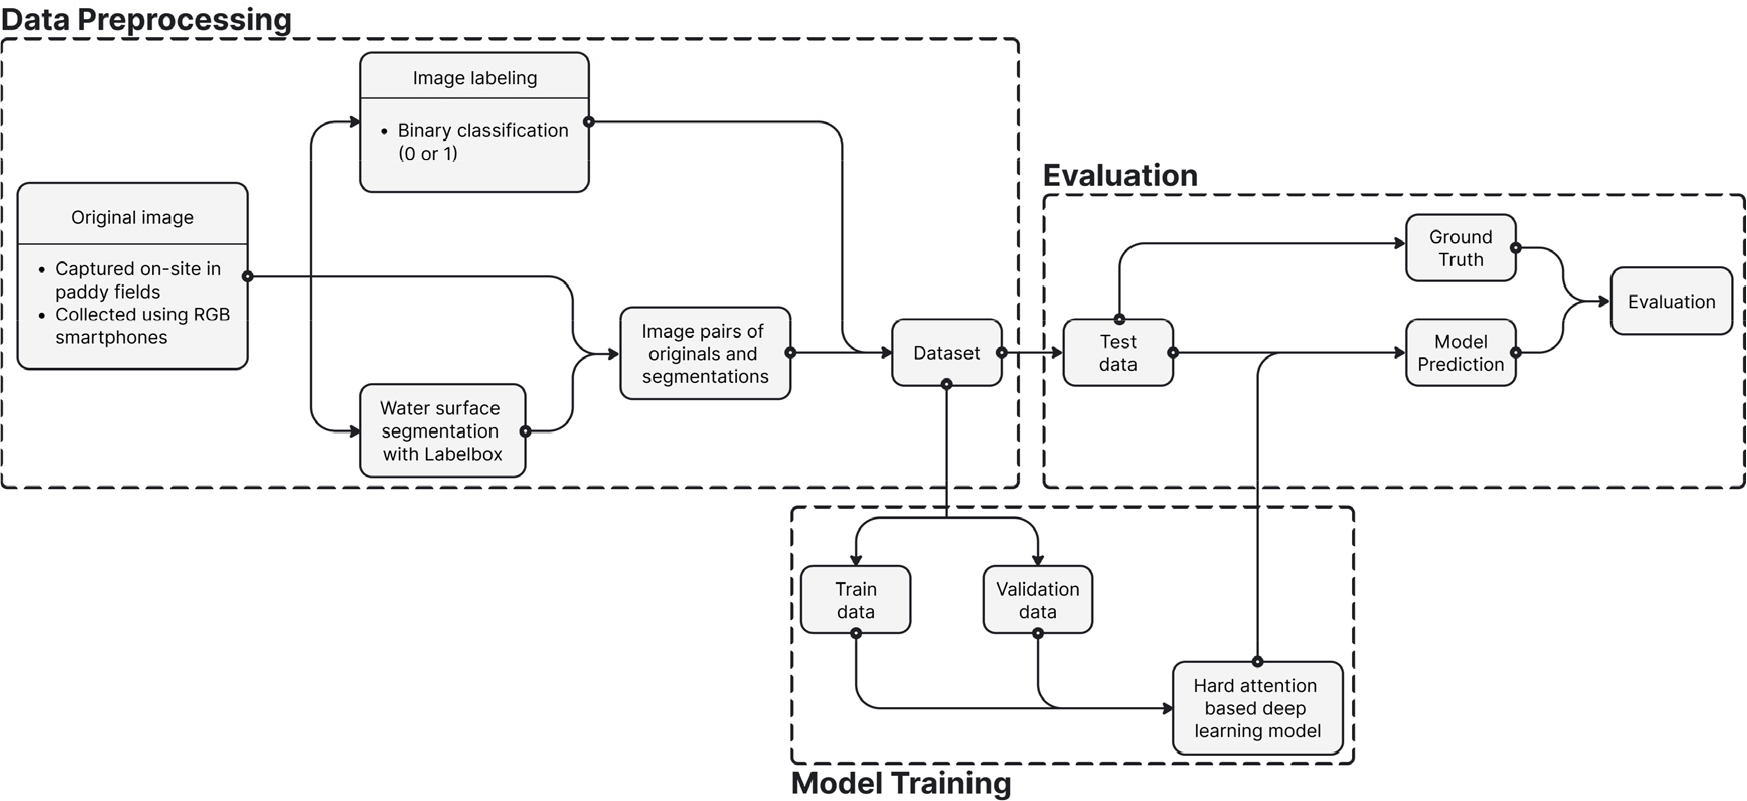
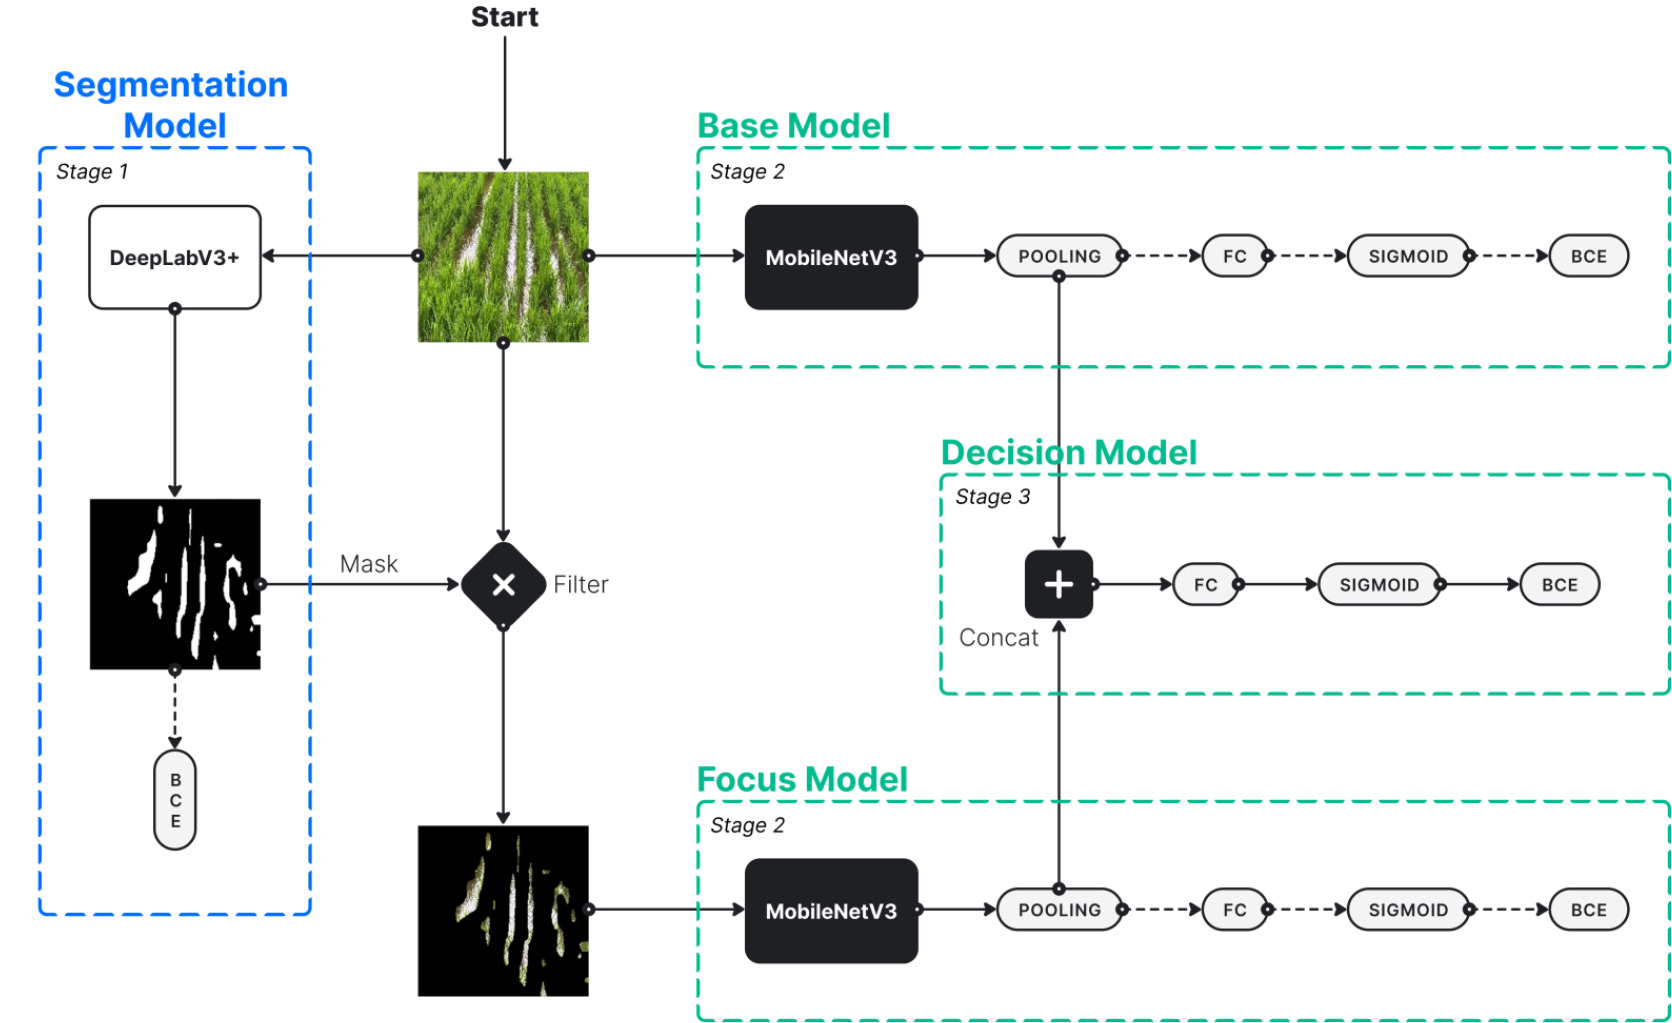
다음으로, 모델의 학습 및 검증을 위해 구축된 이미지-마스크 쌍 데이터 세트를 사용하여 하드 어텐션 기반 딥러닝 모델을 학습시켰다. 본 연구에서는 특징 추출을 위한 베이스 (base) 모델과 포커스 (focus) 모델의 백본 (backbone)으로 MobileNetV3 (Howard et al., 2019)를 채택하였으며, 학습 과정에서는 이진 교차 엔트로피 (Binary Cross Entropy, BCE) 손실 함수를 사용하여 모델의 예측과 실제 레이블 간의 차이를 최소화하도록 최적화를 진행했다. 이 학습 단계에서 모델은 원본 이미지를 입력받아 전역적 특징을 추출하는 베이스 모델과 분할된 수면 영역에 집중하여 지역적 특징을 추출하는 포커스 모델의 정보를 통합적으로 분석하도록 학습된다.
마지막으로, 학습이 완료된 모델의 최종 성능은 학습에 사용되지 않은 테스트 세트를 통해 평가하였다. 모델이 테스트 이미지에 대해 예측한 관개 상태 분류 결과를 실제 정답 (ground truth) 레이블과 비교 분석하였으며, 모델의 성능을 정량적으로 평가하기 위해 정확도 (accuracy), F1-score, ROC 곡선 (Receiver Operating Characteristic Curve)의 AUC (Area Under the Curve) 등 다양한 지표를 활용하였다.
2. 영상자료와 분석 방법
가. 영상자료
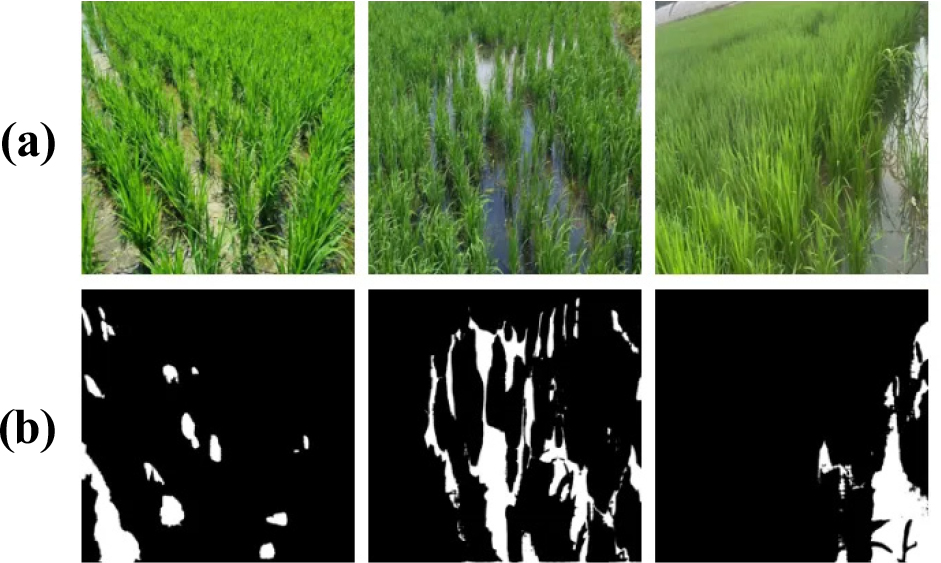
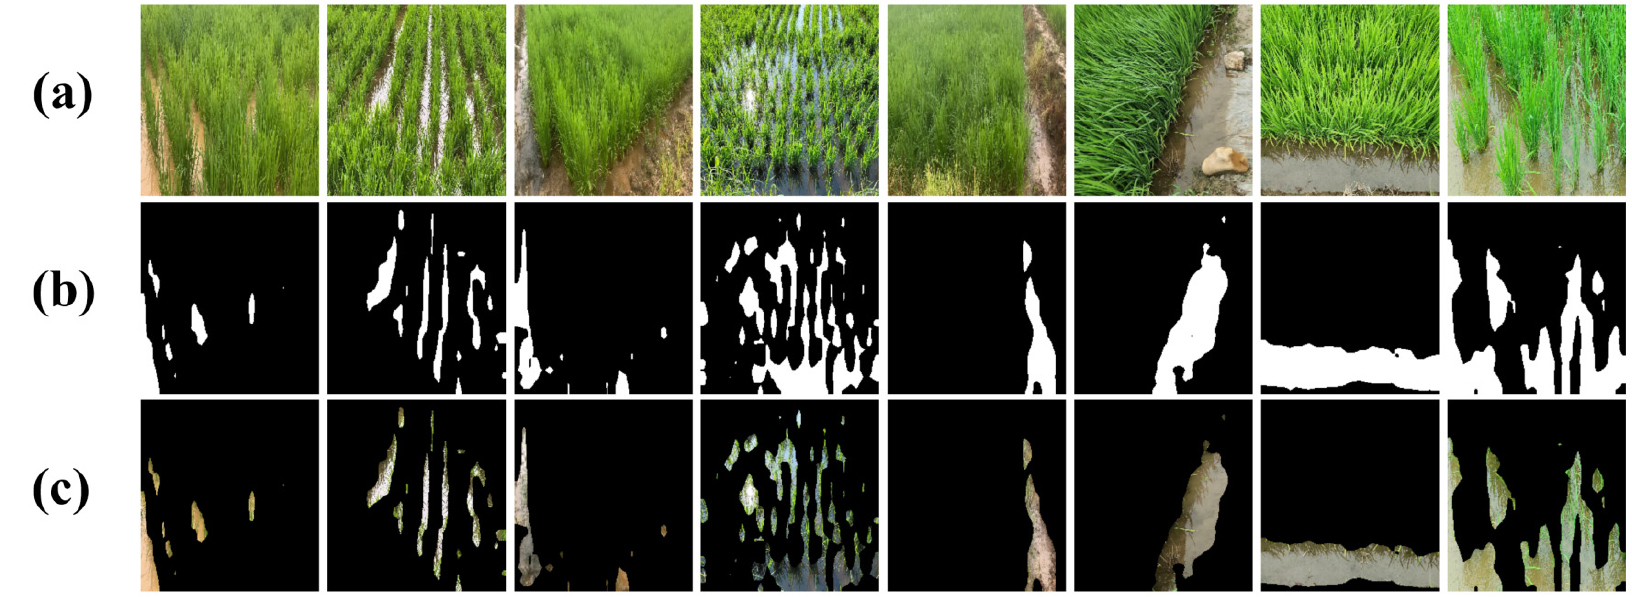
본 연구에서는 경기도 파주시 문산읍에 위치한 논을 대상으로 2023년 7월부터 2024년 6월까지 수집된 이미지 데이터를 사용하였다. 총 507장의 이미지가 수집되었으며, 이 중 담수 상태의 이미지가 295장 (58 %), 비담수 상태의 이미지가 212장 (42 %)으로 구성되어 있다. 세그멘테이션 학습을 위한 수면 라벨링은 상용 어노테이션 도구인 LabelBox를 활용하여 수행하였다. LabelBox의 폴리곤 어노테이션 기능을 통해 수면의 정확한 경계를 수작업으로 표시하였으며, 이는 세그멘테이션 모델 학습을 위한 실제 정답으로 활용하였다. Fig. 2는 원본 이미지와 라벨링된 이미지를 보여준다.
본 데이터셋 (dataset)의 특징 중 하나는 이미지 내 수면의 존재가 실제 관개 상태와 반드시 일치하지 않는다는 점이다. 따라서, 단순 수면 검출에 기반한 분류 방식은 정확한 관개 상태 판별에 한계를 보인다. 이러한 데이터의 복잡성을 효과적으로 처리하기 위해, 본 연구에서는 원본 이미지의 맥락 정보를 학습하는 베이스 모델과 수면에 특화된 포커스 모델을 결합한 통합적 접근법을 제안한다. 이러한 방법론은 단순 수면 검출의 한계를 극복하고 농경지의 실제 관개 상태를 보다 정확하게 분류할 수 있는 가능성을 제시한다.
데이터셋은 모델의 학습 및 평가를 위해 계층적 무작위 추출 (stratified random sampling) 방식으로 분할되었다. 전체 데이터의 60 %는 학습 세트 (304장), 20 %는 검증 세트 (101장), 나머지 20 %는 테스트 세트 (102장)로 할당되었으며, 각 세트에서 담수 상태와 비담수 상태의 비율이 원본 데이터셋의 분포와 동일하게 유지되도록 하였다. 이러한 계층적 분할은 각 세트에서 클래스 분포의 균형을 보장하여 모델 평가의 신뢰성을 높이는데 기여한다.
나. 분석 방법
모든 실험은 NVIDIA RTX A6000 GPU가 장착된 환경에서 PyTorch 프레임워크를 사용하여 수행하였다. 구체적인 전처리 과정은 다음과 같다. 모든 이미지는 ImageNet (Deng et al., 2009)으로 사전 학습된 모델의 표준 입력 크기에 맞추어 224×224로 조정되었으며, 학습 데이터와 동일한 분포로 정규화하기 위해 ImageNet 데이터셋의 평균과 표준편차를 사용하였다. 모델의 최적화를 위해 Adam 옵티마이저 (Kingma and Ba, 2014)를 사용하였으며, 초기 학습률은 0.0001로 설정하였고, 학습의 안정성과 수렴성을 개선하기 위해 7 에포크마다 학습률을 0.5배로 감소시켰다. 배치 크기는 64로 설정하였으며, 세그멘테이션 모델은 1000, 그 외의 모델은 300 에포크 동안 학습을 진행하였다. 모든 모델은 에포크 수를 제외하고 동일한 하이퍼파라미터 설정을 사용하였다. 최종적으로 각 모델의 검증 성능을 기준으로 최적의 모델을 선택하였다. Table 1은 본 연구의 실험 환경과 하이퍼파라미터 설정을 요약하였다.
Table 1.
Experimental environment and hyperparameter settings
3. 모델 구조
Fig. 3은 본 연구에서 적용한 하드 어텐션 기반 딥러닝 모델의 전반적인 구조와 세 단계의 계층적 학습 방식을 보여준다. 첫 번째 단계에선 세그멘테이션 모델이 논 이미지 내 수면을 식별하여 이진 마스크를 생성한다. 두 번째 단계에서는 CNN기반의 베이스 모델과 포커스 모델이 이미지의 핵심 특징을 추출한다. 마지막 단계에서는 완전 연결 계층 (fully connected layer)으로 구성된 디시전 모델이 앞서 추출된 특징들을 최종적으로 분석하여 논의 관개 상태를 담수 또는 비담수로 분류한다. 모든 학습 단계에서는 과적합 방지를 위해 검증 세트를 통한 성능 모니터링을 수행하였으며, 조기 종료 (early stopping) 전략을 사용하여 검증 손실이 가장 낮은 모델을 최종 테스트에 활용하였다.
가. 세그멘테이션 모델
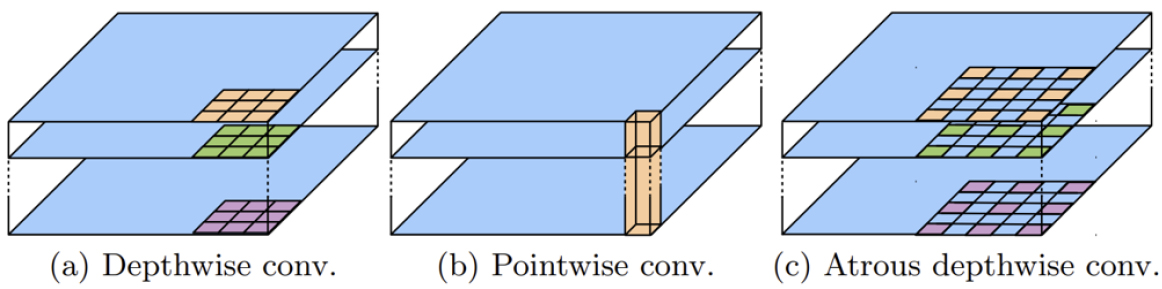
본 연구에선 수면의 정확한 검출을 위해 ImageNet으로 사전 학습된 DeepLabV3+을 파인 튜닝 (fine tuning)하여 사용하였다. Chen et al. (2018)이 제안한 DeepLabV3+는 심층 합성곱 신경망 기반의 의미론적 세그멘테이션 모델로, 인코더 (encoder)-디코더 (decoder) 구조를 개선하여 보다 정교한 세그멘테이션 결과를 생성한다. DeepLabV3+의 핵심적인 특징은 ASPP (Atrous Spatial Pyramid Pooling) 모듈의 활용이다. ASPP는 서로 다른 확장률을 가진 Atrous 합성곱 (Fig. 4(c))을 병렬로 적용함으로써 다양한 스케일의 문맥 정보를 효과적으로 포착한다. 또한, 개선된 디코더 모듈은 인코더의 저수준 특징을 점진적으로 복원하여 세그멘테이션 영역 간의 경계를 정확하게 구분할 수 있다. 이러한 특성은 다양한 환경 조건과 촬영 각도에서도 안정적인 성능을 보장한다. 특히 DeepLabV3+의 다중 스케일 문맥 정보 포착 능력과 정교한 경계 검출 성능은 크기와 형태가 다양한 논의 수면을 효과적으로 검출하는 데 적합하다.
세그멘테이션 모델의 학습을 위해서는 이진 교차 엔트로피 손실 함수를 채택하였다. 이는 이진 분류 문제에 특화된 손실 함수로, 각 픽셀의 예측 확률과 실제 레이블 간의 차이를 효과적으로 측정한다. 이진 교차 엔트로피 손실 함수는 식 (1)과 같이 정의되며, 는 픽셀 의 실제 레이블을, 는 모델의 예측 확률을 나타낸다.
나. 베이스 및 포커스 모델
본 연구에서는 ImageNet으로 사전학습된 MobileNetV3를 백본 모델로 사용하였다. MobileNetV3는 Depthwise Separable Convolution과 Inverted Residual 구조 (Sandler et al., 2018), SE (squeeze-and-excitation; Hu et al., 2018) 모듈, h-swish 활성화 함수 식 (2)를 통합하여 모바일 환경에서 연산 효율성과 성능의 균형을 달성한 경량화된 CNN 구조이다.
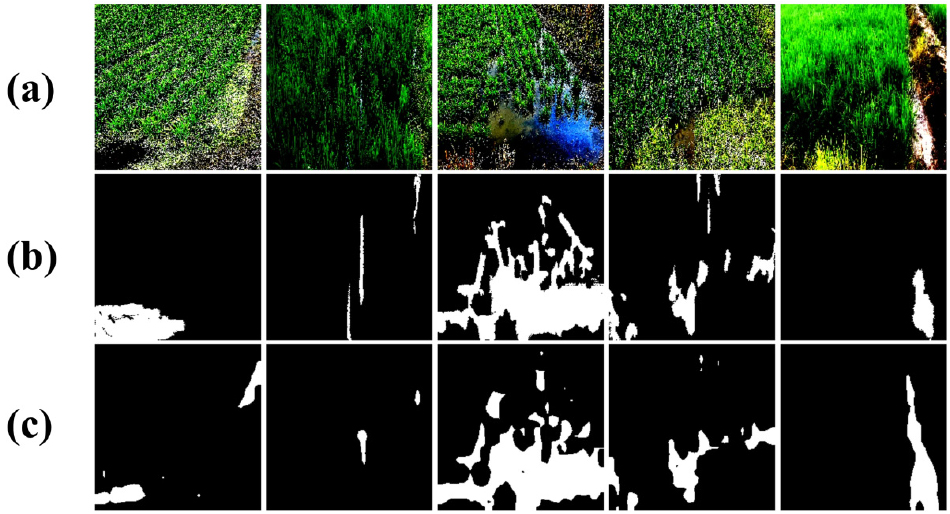
베이스와 포커스 모델의 주요 차이점은 입력 데이터의 특성에 있다. 베이스 모델은 Fig. 5(a)에 제시된 원본 이미지를 입력으로 사용하여 전역적 특징을 학습하는 반면, 포커스 모델은 Fig. 5(c)에 나타난 세그멘테이션 모델을 통해 검출된 수면에 집중하여 지역적 특징을 학습한다. 두 모델은 이진 분류를 위해 최종 완전 연결 계층이 수정된 네트워크 구조를 가지며, 효율적인 학습을 위해 특정 계층을 고정 (freezing)하는 전이 학습 기법을 적용하여 제한된 데이터셋에서도 안정적인 성능을 확보하였다. Appendix A와 B에는 상세한 모델 구조가 기술되어 있으며, 세그멘테이션 모델과 동일하게 식 1의 이진 교차 엔트로피를 손실 함수로 사용하여 학습을 수행하였다.
다. 디시전 모델
디시전 모델은 베이스 모델과 포커스 모델의 특징을 통합하여 최종적인 분류를 수행한다. 구체적으로, 각 모델의 완전 연결 계층 이전에서 추출된 특징 벡터들을 연결 (concatenation)하여 새로운 입력 벡터를 생성하고, 이를 새로운 완전 연결 계층을 통해 처리하여 최종 분류 결과를 도출한다. 자세한 모델 구조는 Appendix C에 나타내었다.
4. 정확성 평가 방법
본 연구에서는 제안된 모델의 성능을 검증하기 위해, 각 단계의 특성에 맞는 평가 지표를 종합적으로 활용하였다. 먼저, 세그멘테이션 모델이 논 이미지 내에서 수면의 공간적 범위를 얼마나 정확하게 식별하는지를 정량적으로 평가하기 위해 정확도 (pixel accuracy), IoU (Intersection Over Union), 그리고 Dice Score를 평가 지표로 활용하였다. 픽셀 정확도는 전체 픽셀 중 올바르게 분류된 픽셀의 비율을 보여주어 모델의 전반적인 성능을 평가하기 위해 사용하였다. 그러나 이 지표는 수면과 같이 특정 객체가 이미지의 일부만 차지하는 클래스 불균형 상황에서는 모델의 실제 예측 능력을 정확히 반영하기 어려울 수 있다.
이러한 한계를 보완하고 모델의 정확성을 더 엄격하게 평가하기 위해 IoU와 Dice Score를 추가적인 지표로 사용하였다. IoU는 모델의 예측 영역과 실제 정답 영역이 얼마나 겹치는지를 측정하고, 거짓 양성과 거짓 음성 모두에 페널티를 부과함으로써 모델의 정밀도를 종합적으로 평가할 수 있다. Dice Score 역시 두 영역 간의 유사도를 측정하는 지표로, IoU와 함께 사용하여 평가의 신뢰성을 높였다. 이러한 지표를 통해 모델이 생성한 수면 마스크가 후속 분류 모델의 입력으로 사용하기에 충분한 수준의 신뢰성을 갖추었는지 판단하였다.
이미지 분류 모델의 성능은 정확도, 정밀도, 재현율, F1-score, 그리고 ROC 곡선의 AUC를 통해 종합적으로 평가하였다. 정확도는 모델의 전반적인 성능을 파악하기 위해 사용하였으며, 정밀도와 재현율의 균형을 종합적으로 고려하기 위해 두 지표의 조화 평균인 F1-score를 사용하였다. 마지막으로, 특정 임계값 설정에 의존하지 않고 모델의 성능을 평가하기 위해 ROC 곡선의 AUC를 사용하였다. 사용한 평가 지표의 식은 Table 2에 정리하여 나타내었다.
Ⅲ. 결과 및 고찰
1. 세그멘테이션 모델
Fig. 6은 세그멘테이션 모델의 학습 및 검증 손실값의 변화를 1,000 에포크에 걸쳐 나타낸 결과를 보여준다. 학습 손실은 0.6에서 시작하여 약 30 에포크까지 급격히 감소해 0.1 수준에 도달한 후, 완만한 기울기로 지속적으로 감소하며 모델 학습의 안정성을 나타냈다. 반면 검증 손실은 약 30 에포크까지 빠르게 감소하여 0.2 수준에 도달했으나, 이후 1,000 에포크까지 점진적으로 증가하는 경향을 보였다. 학습 손실의 지속적 감소와 검증 손실의 증가 양상은 약 100 에포크 이후부터 모델이 과적합되기 시작했음을 의미한다. 따라서 조기 종료 전략에 의해 검증 손실이 최소값에 도달한 86 에포크의 모델을 테스트 데이터셋에 적용하여 성능을 평가하였다.
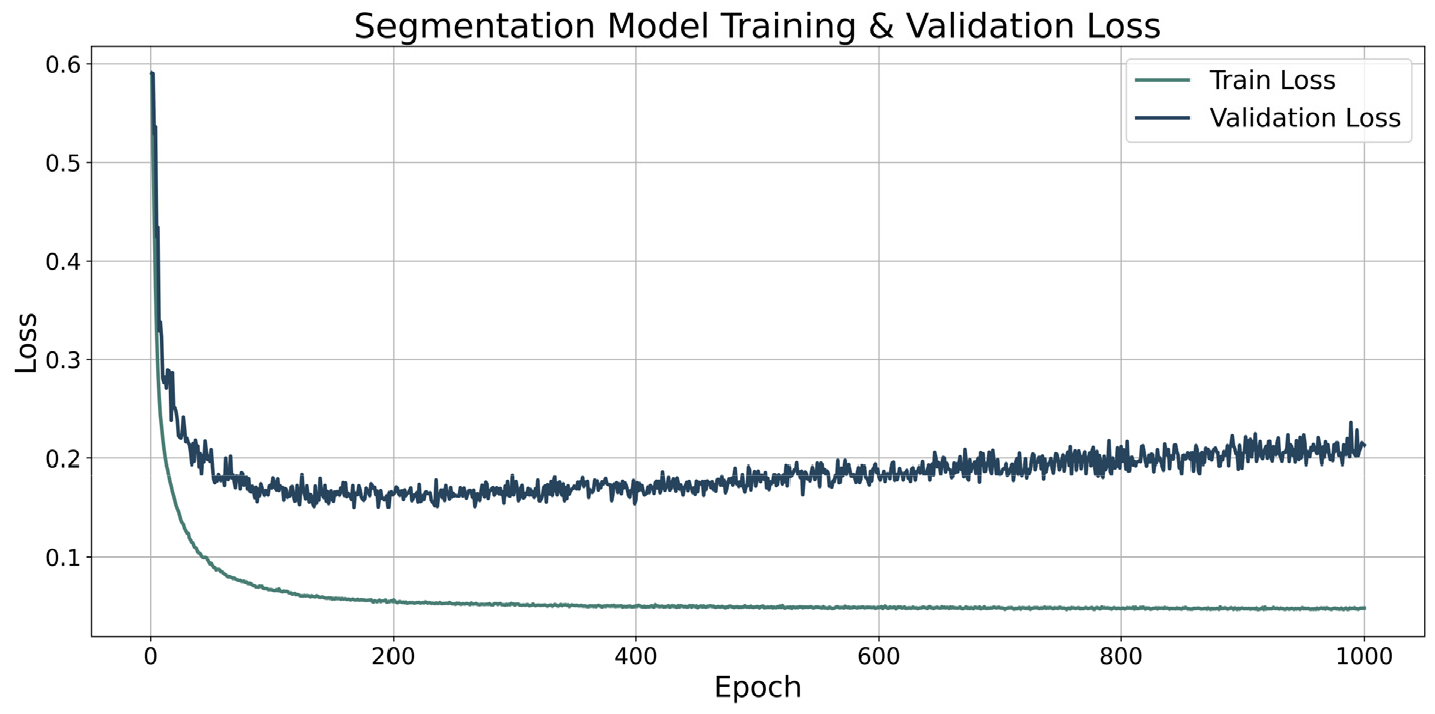
Table 3에서 나타난 해당 모델의 평가 결과는 94 %의 픽셀 정확도를 달성하였고 IoU와 Dice Score는 각각 0.45와 0.54를 기록하였으며, 최종 학습 손실은 0.0563, 검증 손실은 0.1277 수준임을 확인할 수 있다. Fig. 7에는 모델의 세그멘테이션 성능을 시각적으로 분석한 결과를 나타내었다. 전처리된 원본 영상, 정답 마스크, 그리고 모델이 예측한 세그멘테이션 마스크의 비교 분석을 통해 복잡한 지형적 특성이 존재하는 영역에서 모델의 성능이 제한되는 경향을 관찰할 수 있었다. 특히, 수심이 얕아 바닥이 노출되거나 식생이 혼재된 영역에서는 수면 경계 검출의 정확도가 더욱 저하되는 현상이 확인되었다. 그럼에도 불구하고 본 모델은 대부분의 수면을 안정적으로 검출하였으며 전반적인 수면 분포 특성을 효과적으로 포착하는 것으로 생각된다. 이러한 결과는 후속 분류 모델의 입력으로 활용하기에 적합한 수준이나, 낮은 IoU (0.45), Dice Score (0.54)와 과적합 경향은 분류 성능을 제약할 수 있다. 따라서 향후 데이터 확충과 클래스 불균형에 강건한 손실 함수의 적용을 통해 경계 정밀도 향상이 요구된다.
Table 3.
Evaluation results of the segmentation model
| Test Metrics | Losses | |||
| Pixel Accuracy | IoU |
Dice Score |
Train Loss | Validation Loss |
| 0.94 | 0.45 | 0.54 | 0.0563 | 0.1277 |
2. 이미지 분류 모델 학습
가. 베이스 및 포커스 모델
Fig. 8은 모델 구조에 따른 학습 결과를 보여준다. 먼저, 가장 기본적인 베이스 모델과 수면 정보만을 활용한 포커스 모델의 성능을 비교함으로써, 모델 개선 전략의 효과를 검증하였다.
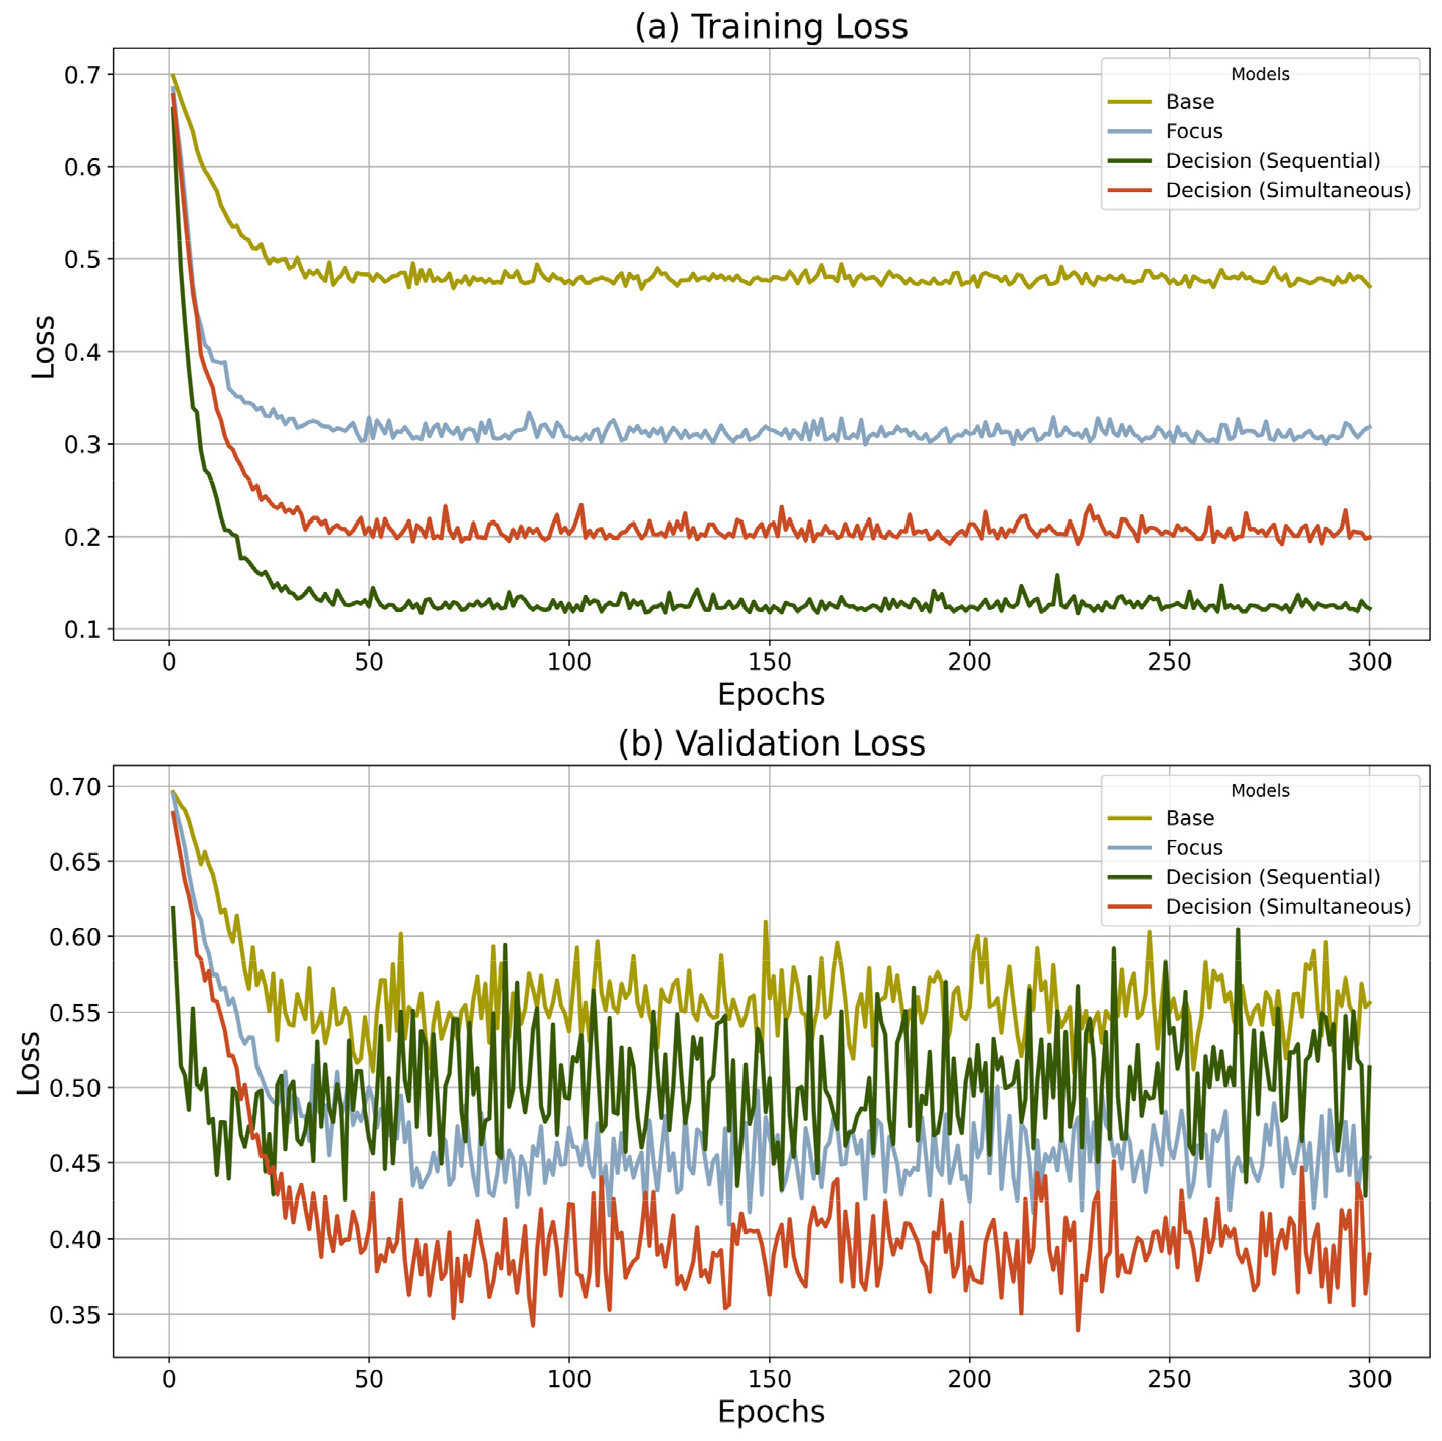
베이스 모델의 경우, 학습 초기 단계에서 손실이 급격히 감소하는 양상을 보였으나, 약 50 에포크 이후 약 0.47 수준에서 수렴한 후 추가적인 성능 향상을 보이지 못했다. 검증 손실은 약 0.55에서 안정화되었으며, 학습 손실과의 격차가 상대적으로 작았음에도 불구하고 과소적합 (underfitting) 현상을 나타내었다. 이에 반해, 포커스 모델의 학습 손실은 베이스 모델보다 더 깊게 수렴하여 약 0.30 수준에 도달하였다. 검증 손실 또한 약 0.41로 개선되어 우수한 일반화 성능을 보였다. 이는 수면 정보에 집중하도록 설계된 구조가 모델의 학습 능력을 향상시켰기 때문으로 생각된다.
나. 디시전 모델
디시전 모델은 베이스 모델과 포커스 모델을 통합하여, 더욱 정교한 추론 과정을 도입한 구조이다. Fig. 8에서는 동일한 디시전 구조라도 학습 전략에 따라 모델의 안정성과 일반화 성능이 달라질 수 있음을 보여준다. 본 연구에선 두 가지의 디시전 모델 학습 방법을 비교하였다. 첫 번째로 순차적 (sequential)으로 학습된 디시전 모델은 베이스 모델과 포커스 모델을 각각 독립적으로 사전 학습 (pre-training)한 후, 이들의 특징 추출기로부터 획득한 가중치 파라미터를 초기값으로 활용하여 학습을 수행하였다. 반면, 두 번째로 동시 (simultaneous)에 학습된 디시전 모델은 사전 학습 단계를 생략하고 종단간 학습 (end-to-end learning)을 수행하였다.
Fig. 8(a)의 학습 손실 곡선에서 두 디시전 모델은 모두 포커스 모델보다 낮은 최종 손실 값을 보인다. 특히, 순차 디시전 모델은 약 0.12라는 가장 낮은 학습 손실을 나타내었으며, 동시 디시전 모델 또한 약 0.19의 낮은 학습 손실을 보였다. 그러나 Fig. 8(b)의 검증 손실에서는 두 디시전 모델이 서로 다른 결과를 보였다. 동시 디시전 모델은 약 0.34의 검증 손실을 기록하여 전체 모델 중 가장 우수한 일반화 성능을 나타내었다. 반면, 순차 디시전 모델은 가장 낮은 학습 손실에도 불구하고 평균적으로 포커스 모델을 상회하는 결과를 보였다.
이러한 결과는 순차 디시전 모델에서 과적합 (overfitting) 현상이 발생하였음을 시사한다. 특히 주목할 점은 Fig. 8(b)의 검증 손실 곡선에서 순차 디시전 모델만이 20-30 에포크 구간에서 약 0.44 수준에 도달한 후 손실값이 다시 상승하는 명확한 과적합 패턴을 보인다는 것이다.
순차적 학습 방식은 사전 학습된 베이스 모델과 포커스 모델의 가중치를 활용하기 때문에 상대적으로 적은 에포크로도 충분한 학습이 가능하다. 그러나 이러한 특성으로 인해 다른 모델에 비해 빠르게 과적합되는 경향을 보이는 것으로 판단된다. 따라서, 순차적 학습 방식을 적용할 때는 검증 손실의 변화를 지속적으로 모니터링하여 적절한 시점에서 학습을 중단하는 조기 종료 전략이 모델의 일반화 성능을 보장하는 데 필수적이라 생각된다.
3. 모델 성능 평가
가. 정확도
Fig. 9는 각 모델의 학습 과정에서 도출된 최소 검증 손실 모델을 대상으로, 테스트 데이터 셋에 대해 임계값 (threshold)을 0.1부터 0.9까지 조정하며 정확도를 평가한 결과를 나타낸다. 베이스 모델은 전체 임계값 구간에서 전반적으로 저조한 성능을 보였다. 임계값 0.5에서 0.79의 정확도를 기록했으나, 임계값이 0.1, 0.9일 때 0.58로 양 극단에서 매우 저조한 성능을 나타냈다. 수면 정보를 활용한 포커스 모델은 베이스 모델 대비 상당한 성능 향상을 보였으며, 임계값 0.5-0.8 구간에서 약 0.80 정도의 안정적인 정확도를 유지하였다.
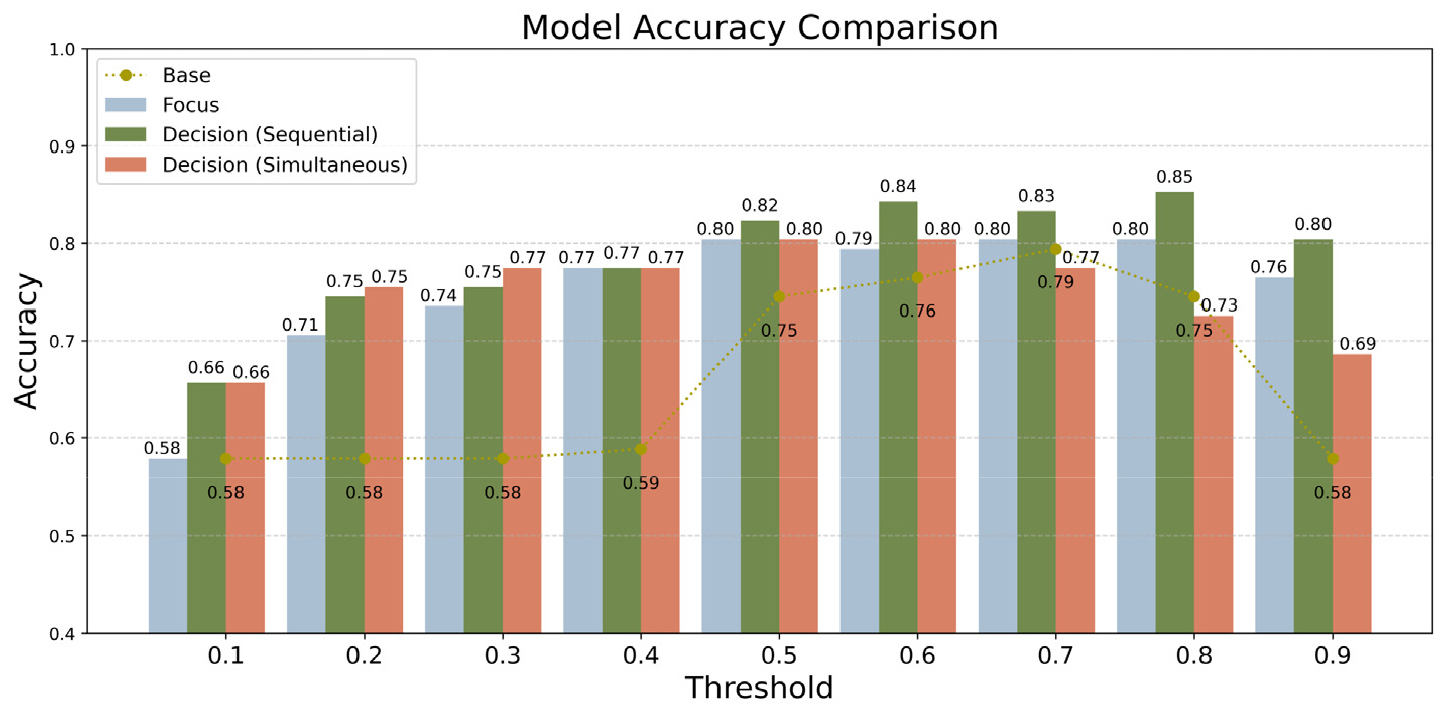
두 가지 학습 전략을 사용한 디시전 모델은 서로 다른 결과를 보였다. 동시 디시전 모델은 임계값 0.5, 0.6에서 0.80의 정확도를 기록하는 등 여러 구간에서 베이스 모델보다 유사하거나 약간 뛰어난 성능을 보였으나, 높은 임계값에선 포커스 보다 낮은 정확도를 나타냈다. 반면, 순차 디시전 모델은 전체 모델 중 가장 뛰어난 정확도를 달성하였다. 특히, 임계값 0.8에서 0.85라는 가장 높은 정확도를 기록하였다.
나. F1-score
Fig. 10은 각 모델의 학습 과정에서 도출된 최소 검증 손실 모델을 대상으로, 테스트 데이터 셋에 대해 임계값을 0.1부터 0.9까지 조정하며 F1-score를 평가한 결과를 보여준다. 베이스 모델의 취약점은 F1-score에서 더욱 극명하게 나타난다. 임계값 0.5-0.7에서 0.81의 F1-score를 기록함에도 불구하고, 임계값이 0.9로 높아지자 0.44로 급격하게 낮아지는 것을 확인할 수 있다. 이는 높은 임계값에서 베이스 모델이 대부분의 담수 상태를 탐지하지 못하여 재현율이 매우 낮아지는 현상을 의미한다. 포커스 모델은 F1-score에서도 로버스트 (robust)한 성능을 보였다. 임계값 0.4-0.7 구간에서 0.83 이상의 성능을 유지했으며, 임계값 0.9에서 0.66으로 감소하였으나, 베이스 모델의 하락에 비하면 훨씬 안정적인 경향을 나타냈다. 동시 디시전 모델은 임계값 0.6 이전에선 포커스 모델과 유사한 성능을 보였으나, 0.7 이후 포커스 모델보다 확연히 낮은 성능을 나타냈다.
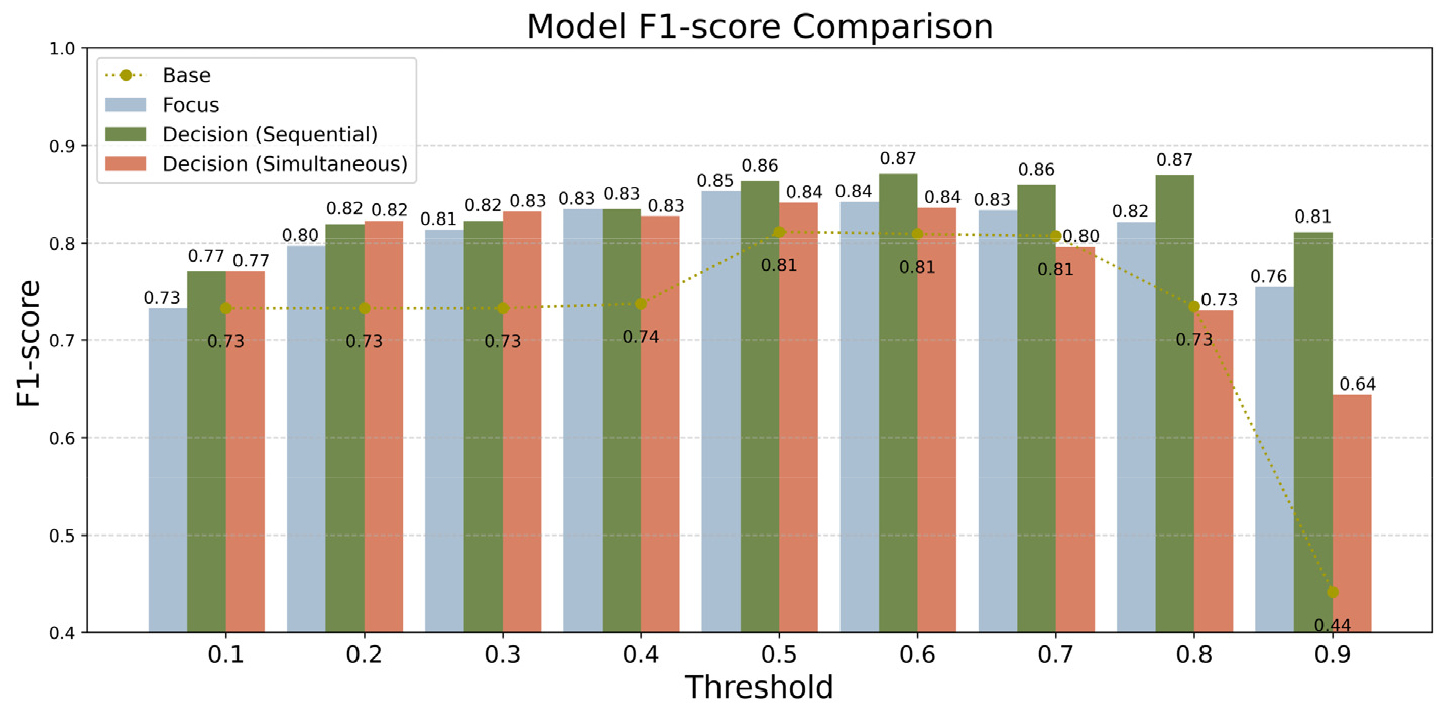
정확도와 마찬가지로 순차 디시전 모델은 가장 뛰어난 성능을 보였다. 임계값 0.6, 0.8에서 0.87이라는 가장 높은 F1-score를 달성했을 뿐만 아니라, 다른 모델이 심각한 성능 저하를 겪는 임계값 0.9에서도 0.81이라는 높은 F1-score를 유지하였다. 정확도와 재현율은 상충 관계에 있어, 임계값이 높아질수록 정확도는 증가하나, 재현율은 감소하는 경향을 보인다. 따라서, 순차 디시전 모델이 높은 임계값에서도 안정적인 F1-score를 유지하는 것은, 이 모델이 담수 상태에 대하여 매우 높은 확신도 (confidence)를 가짐을 의미한다.
다. ROC-AUC
Fig. 11의 ROC 곡선은 각 모델의 분류 성능을 비교하여 보여준다. AUC 값을 기준으로 분석해 보았을 때 순차 디시전 모델이 AUC 0.915로 가장 우수한 성능을 나타냈으며, 이어서 포커스 모델 (AUC 0.898), 베이스 모델 (AUC 0.863), 동시 디시전 모델 (AUC 0.862) 순으로 분류 성능을 보였다.
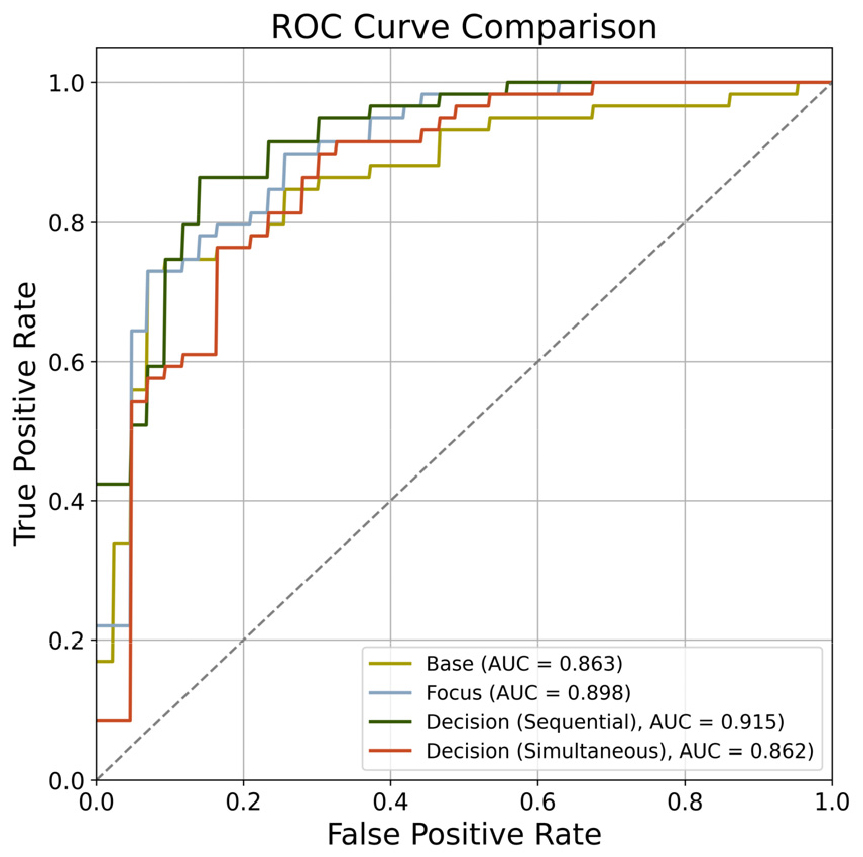
베이스 모델과 포커스 모델 사이의 성능 차이는, 모델이 수면 영역에 집중할 수 있도록 유도하는 하드 어텐션 메커니즘이 매우 효과적임을 나타낸다. 그럼에도 불구하고, 하드 어텐션 메커니즘을 사용한 동시 디시전 모델은 네 가지 모델 중 가장 낮은 성능을 보였다. 이러한 결과는 디시전 모델의 학습 전략이 성능에 유의미한 영향을 줄 수 있음을 시사한다.
라. 학습 결과
Table 4는 네 모델에 대한 학습 및 성능 평가 결과를 보여준다. 원본 이미지만을 학습한 베이스 모델과 비교하였을 때, 하드 어텐션 메커니즘을 통해 수면 영역에 집중한 포커스 모델이 더 우수한 성능을 보였다. 이는 하드 어텐션 접근 방식이 관개 상태 분류에 효과적임을 나타낸다.
Table 4.
Summary of performance metrics by model type
또한, 동일한 디시전 구조라도 학습 전략에 따라 성능이 뚜렷하게 갈렸다. 순차적으로 학습한 디시전 모델은 검증 손실을 제외한 네 지표 (학습 손실, AUC, 정확도, F1-score)에서 가장 뛰어난 결과를 달성한 반면, 동시에 학습한 디시전 모델은 AUC 0.862로 오히려 네 모델 중 가장 낮은 값을 기록하였다. 이는 베이스·포커스 특징을 결합하는 디시전 구조 자체가 성능 향상을 보장하는 것이 아니라, 사전 학습된 특징 추출기를 초기값으로 활용하는 순차적 학습과 결합될 때 비로소 통합 구조의 이점이 발현됨을 시사하며, 동시 학습 모델은 두 백본을 함께 최적화하는 과정에서 전역적·지역적 특징의 분화가 충분치 않아 성능이 제한된 것으로 판단된다.
다만, 검증 손실 측면에서는 동시에 학습된 모델이 안정적인 수렴 양상을 보인 반면, 순차적으로 학습된 모델은 초기 감소 후 점진적으로 증가하는 과적합 패턴을 보였다. 이는 베이스 및 포커스 단계에서 이미 충분한 학습이 이루어져 추가적인 미세 조정에 민감하게 반응한 것으로, 조기 종료, 학습률 스케쥴러 (learning rate scheduler) 같은 정규화 기법의 적용과 학습률, 배치 크기, 에포크 수 등의 하이퍼파라미터 최적화를 통한 과적합 제어가 중요함을 시사한다.
마. 추론 효율성
모델의 경량·모바일 환경 적용 가능성을 검증하기 위해 GPU를 사용하지 않는 AMD EPYC 9654 CPU 단독 환경에서 단일 이미지 추론 성능을 측정하였으며, 그 결과를 Table 5에 정리하였다. 베이스, 포커스 특징을 통합하는 디시전 모델은 8.9 MB 크기로 CPU 단일 스레드에서 8.7 ms의 지연 시간과 초당 약 115장의 처리량을 보여 MobileNetV3+ 기반 분류부가 GPU 없이도 경량으로 동작함을 확인하였다. 반면 세그멘테이션을 포함한 전체 파이프라인은 177.3 MB, 574.3 ms의 지연 시간과 초당 약 1.7장의 처리량으로, 두 수치의 차이로부터 전체 추론 비용의 대부분을 세그멘테이션 백본이 차지함을 알 수 있다.
Table 5.
Inference efficiency of the decision model and end-to-end pipeline in a CPU-only environment
| Component | Model Size (MB) | Latency (ms) | Throughput (images/s) |
| Decision Model | 8.9 | 8.7 | 115.2 |
| End-to-End Pipeline | 177.3 | 574.3 | 1.7 |
다만 본 측정은 고성능 CPU 환경에서 수행되어 실제 스마트폰의 추론 시간과는 차이가 있으며, 절대적인 속도보다 CPU 단독 추론의 가능성과 구성요소별 상대 비용을 보여주는 자료로 이해하는 것이 적절하다. 향후 세그멘테이션 백본을 경량 모델로 대체하면 전체 추론 비용을 더욱 줄일 수 있을 것으로 판단된다.
Ⅳ. 요약 및 결론
기후변화 대응을 위한 농업 분야의 핵심 과제 중 하나는 논에서 발생하는 메탄가스 배출 문제이다. 논 토양의 혐기적 환경이 메탄 생성의 주요 원인이 되고 있어, 농림축산식품부는 탄소중립 정책의 일환으로 논물떼기 시행 농가에 보조금을 지원하는 시범사업을 추진하고 있다. 그러나 이러한 정책의 실효성을 높이기 위해서는 논물떼기 이행 여부를 정확하고 효율적으로 모니터링할 수 있는 방법이 필요하다.
이러한 문제를 해결하기 위해 본 연구에서는 논 관개 상태를 분류할 수 있는 하드 어텐션 메커니즘 기반의 딥러닝 모델을 제안하였다. 제안된 모델은 세그멘테이션 모델이 생성한 수면 정보를 기반으로, 전체 이미지를 분석하는 베이스 모델과 수면 영역에 집중하는 포커스 모델의 특징을 디시전 모델이 통합하는 구조로 설계되었다. 이러한 통합적 접근법은 개별 모델의 한계를 상호 보완하여 분류 정확도를 크게 향상시켰으며, 특히 순차적으로 학습하는 전략을 적용한 모델이 안정성과 성능 측면에서 가장 우수한 결과를 보여주었다. 본 모델은 농업인이 제출한 논 이미지의 담수, 비담수 여부를 자동으로 선별하여, 육안 판독과 현장 점검에 의존하는 현행 이행점검의 부담을 줄이고 광범위한 대상지를 신속하게 모니터링하는 보조 도구로 활용될 수 있다. 이는 보조금 시범사업의 확대를 뒷받침하고, 논 메탄 배출 저감을 목표로 하는 탄소중립 정책의 실효성 제고와 농업 부문의 데이터 기반 기후변화 대응에 기여할 것으로 기대된다.
하지만 순차적으로 학습하는 전략은 과적합의 위험이 있어 적절한 정규화 기법의 적용이 필요할 것으로 사료된다. 또한, 본 연구에서 사용된 507장의 이미지는 다양한 논 환경과 기상 조건, 계절적 변화를 완전히 반영하기에는 규모와 다양성 측면에서 제약이 있다. 향후 연구에서는 지역적 다양성을 확보하고 계절 변화를 포괄하는 대규모 데이터셋 구축을 통해 모델의 일반화 성능을 향상시키고, 실제 현장에서의 안정적인 적용 가능성을 검증할 필요가 있을 것으로 판단된다.